扩散/流匹配去模糊调研:从 SD 先验到一步化与残差流(2025→2026)
1. 概述与范围
时间窗:2025-01 至 2026-07。任务:单图像去模糊,分两块——(A) 通用图像去模糊(运动模糊为主,兼顾散焦/盲复原,§2);(B) 人脸去模糊 / 盲人脸复原(§3,扩散时代人脸去模糊被 BFR 吸收,见 §3 开头口径说明)。范围口径:只收「用扩散或流匹配作为生成核心」的方法,不含纯回归 Transformer(Restormer / FFTformer / LoFormer 等只作为被对比或被增强的基线出现)。优先级:有模型、有代码的优先——每条会在卡片和对比矩阵里标注代码真实状态(已放权重 / 只放脚本 / 占位仓库),每篇核心工作配从原论文裁剪的架构主图。
这个领域 2025 年在争什么。去模糊长期是回归任务的天下(PSNR 导向),扩散进来带的是感知真实感(纹理、细节幻觉),代价是两条:一是多步采样太慢(去模糊要落地到相机 ISP,20~50 步不可接受),二是保真度塌陷(SD 的隐空间 VAE 把 PSNR 打到 24 dB 级,比回归方法低 8~9 dB)。2025→2026 的工作几乎都在回应这两条:一步化(OSDD、FideDiff、DeblurFlow 的 r-space、ELIR 的 consistency)和把扩散的端点重构成"模糊"而非"噪声"(FideDiff 的模糊轨迹、BlurDM 的双扩散、DeblurFlow 的残差场),让生成过程天然对齐复原目标而非从纯噪声幻觉。
验证声明:下列每个 arxiv 号、发表年份、会议、代码库状态均在本次调研中联网核实(arxiv 前缀年月已逐一确认,如 2502=2025-02、2605=2026-05)。代码交叉验证见 §6——凡说某函数"实现了 X",均已打开该文件确认,未打开的明确标注。仓库内本无去模糊分析,本篇为新建;相邻的diffusion-sr-2026(扩散超分一步化)与opd-diffusion-2026(一步扩散)可交叉参照,一步化的方法论在超分与去模糊之间高度共享。
一句话地图:〔通用去模糊〕把预训练 SD 当先验(DeblurDiff、OSDD)→ 把扩散过程本身改造成去模糊(FideDiff、BlurDM)→ 摆脱配对/预训练(TP-Diff 非配对、DeblurSDI 零样本)→ 用流匹配的残差重参数化(DeblurFlow);〔人脸去模糊/BFR〕主战场从"去糊"转向"保身份 + 反幻觉"——身份即提示(FaceMe)→ 一步 + 反幻觉(HonestFace)→ 高质人脸先验(AuthFace)→ 高效码本对齐(LAFR)+ 流匹配(ELIR)。
2. 逐篇精要:通用图像去模糊
2.1 DeblurDiff —— 用 LKPN 预测隐空间空变卷积核,驯服 SD 先验
DeblurDiff (NeurIPS 2025, arxiv:2502.03810) — ✅ verified
- 核心贡献:在 SD 隐空间里同训一个隐核预测网络 LKPN,用它预测的逐像素空变卷积核去自适应处理输入特征,从而在保结构的前提下引导 SD 生成——解决"直接拿模糊图/预去模糊图当条件"要么结构提不准、要么过度依赖控制网的两难。
- 方法:LKPN(Latent Kernel Prediction Network)+ 逐元素自适应卷积 EAC(element-wise adaptive convolution),随扩散步迭代精化核估计。
- 关键结果:真实域感知指标领先——GoPro 上 LPIPS 0.2191(DiffBIR 0.2772 / PASD 0.2984);真实模糊图 NIQE 3.66(PASD 4.45)。但 PSNR 明显低(GoPro ~24.32,回归法 HI-Diff 33.33),是 SD 隐空间保真的固有代价。
- 代码:github.com/kkkls/DeblurDiff(MIT,~65★,train.py/inference.py + Google Drive 权重齐全,基于 DiffBIR)。
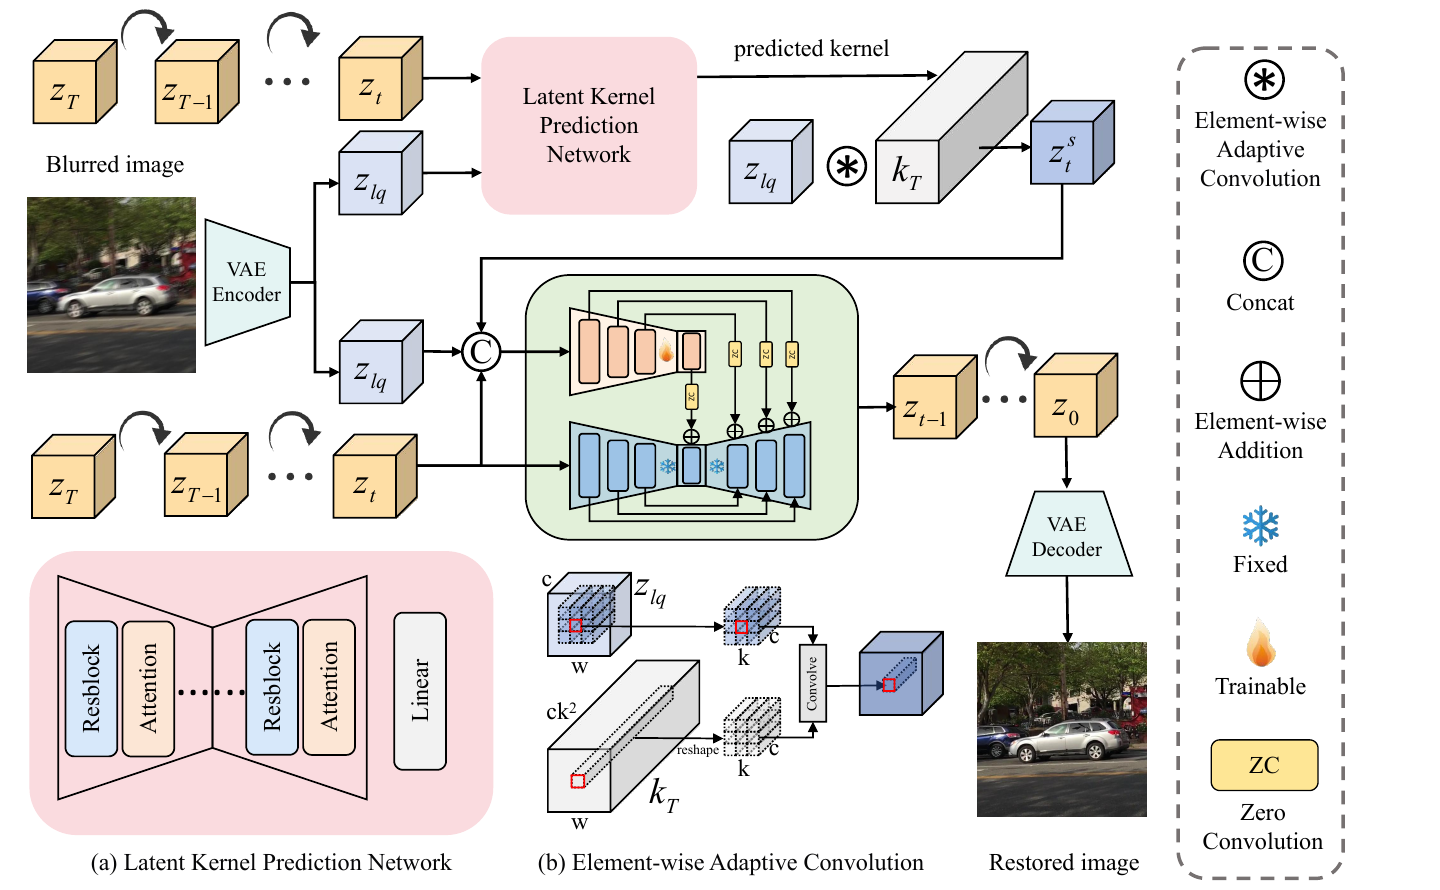
z_lq;LKPN 以噪声隐码 + z_lq 预测逐像素空变卷积核 k_T,经 EAC(⊛)卷积得对齐隐码,作为 ControlNet 条件注入冻结的 SD UNet;左下插图为 EAC 把核 reshape 成 ck² 后与 z_lq 卷积的细节。这张图让"用预测核对齐特征、而非直接喂模糊图"的核心设计一目了然。(论文 Fig. 3)怎么做的:把一张模糊图先过 VAE 编码进 SD 隐空间,LKPN 以模糊隐码为输入,为每个空间位置预测一组卷积核权重(张量形状 (B, groups, kH, kW, H, W)——注意核随 (H,W) 而变,这正是"空变"),EAC 用这些核去卷输入特征,得到的对齐特征作为 ControlNet 式条件注入冻结的 SD UNet。关键设计取舍:为什么不直接把模糊图/预去模糊图喂给 ControlNet?作者的论点是——喂原始模糊图,控制网提不出干净结构;喂预去模糊图,网络会过度信赖那个可能已经出错的中间结果。LKPN 与扩散联合训练、且每个扩散步都用当前去噪结果反过来精化核,让核估计和生成互相纠偏,这是它比"一次性预去模糊 + 扩散精修"两段式管线更鲁棒的原因。代价写在数字里:它把宝押在感知真实感(no-reference 指标全面领先),放弃了 PSNR——这也是下面 FideDiff 要正面反驳的点。
2.2 OSDD —— 一步 SD 去模糊,用 eVAE 补回结构保真
OSDD / One-Step Diffusion for Motion-Deblurring (arxiv:2503.06537, 2025-03) — ✅ verified
- 核心贡献:把 SD 去模糊压到单步去噪,同时用**增强 VAE(eVAE)**专门补回一步化后丢失的结构保真。
- 方法:单步扩散 + eVAE(改善结构重建)+ 动态双适配器 DDA(Dynamic Dual-Adapter,平衡感知质量与保真)+ 一套高质量合成数据缓解感知塌陷。
- 关键结果:GoPro LPIPS 0.1211 / DISTS 0.0606;RealBlur-J LPIPS 0.1178;单步推理 0.88 s/图(GoPro)。只报感知指标(LPIPS/DISTS/无参考),不报 PSNR/SSIM——延续 DeblurDiff 的"感知优先"立场。
- 代码:github.com/xyLiu339/OSDD(⚠️ 占位仓库,代码/权重 TODO 未放,~21★)。
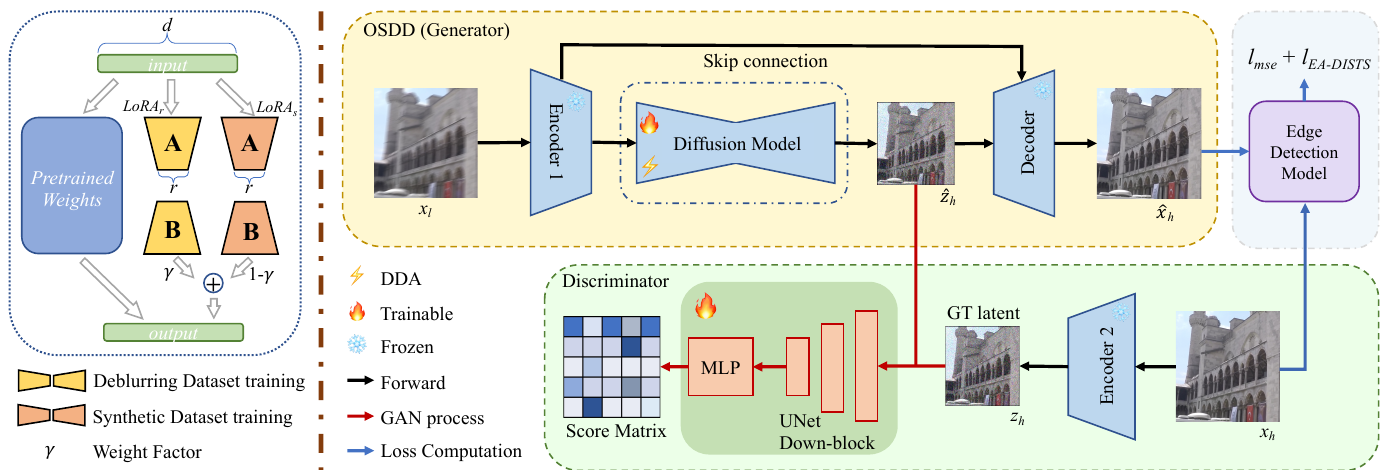
γ 与 1−γ 加权融合;右为单步扩散生成器(Encoder→单步 DM→Decoder)+ 边缘检测的 EA-DISTS 损失 + 判别器 GAN 分支。图右半清楚说明"一步生成"如何靠 eVAE 与判别器补回保真。(论文 Fig. 4)怎么做的:思路是 SD-先验路线(同 DeblurDiff)叠加超分领域已经跑通的一步蒸馏(参见diffusion-sr-2026里的 OSEDiff 系)。难点在于一步化会同时伤保真:VAE 的编解码本就有信息损失,再叠单步生成,结构会飘。OSDD 的两个抓手——eVAE 针对性重训解码端补结构、DDA 在感知分支与保真分支间动态加权——都是冲着"一步但别塌"去的。它和 DeblurDiff 是同一作者群(Yulun Zhang 组)的连续工作,可看作 DeblurDiff 的加速版。代码尚未释放,落地需等;这也是把它排在有完整代码的 DeblurDiff/BlurDM 之后的原因。
2.3 FideDiff —— 把模糊本身当扩散轨迹,一致性模型一步高保真
FideDiff (ICLR 2026, arxiv:2510.01641) — ✅ verified
- 核心贡献:重构扩散过程——让每个 timestep 对应"逐渐加深的模糊图"而非加噪图,训练一致性模型把整条模糊轨迹对齐到清晰输出,实现一步且高保真的运动去模糊。
- 方法:模糊即扩散轨迹 + consistency model + Kernel ControlNet(估模糊核)+ 自适应 timestep 预测。
- 关键结果:GoPro 单步 PSNR 28.79 / SSIM 0.9148 / LPIPS 0.0831;RealBlur-J PSNR 28.96。相对扩散基线大幅领先:DiffBIR +2.64 dB(26.15→28.79)、OSEDiff +4.45 dB、Diff-Plugin +5.91 dB。首次让扩散去模糊在全参考指标上追平 SOTA。
- 代码:github.com/xyLiu339/FideDiff(⚠️ 占位仓库,2026-06 放了可视化结果,代码/数据尚未释放,~20★,CC BY 4.0)。
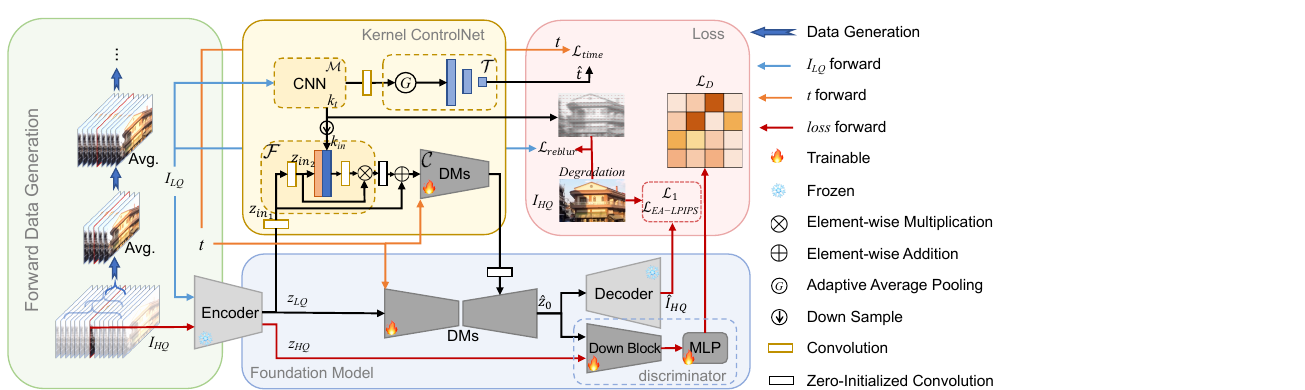
t 生成 I_LQ;(2) Kernel ControlNet 估模糊核 k_t 与自适应时间步 t̂ 注入 DM UNet;(3) 一致性 Foundation Model 一步重建 HQ;(4) L1 / EA-LPIPS / GAN / reblur 损失。图 (1) 把"沿模糊轨迹反向走"这一与噪声扩散的根本区别画了出来。(论文 Fig. 4)怎么做的:这是本调研里概念最漂亮的一篇。标准扩散从纯高斯噪声生成,端点与"去模糊"无关,所以 SD 先验路线才会牺牲 PSNR。FideDiff 把 forward 过程直接定义在模糊维度上:t=0 是清晰图,t 增大是越来越糊的图,于是"去模糊"就是沿这条物理有意义的轨迹反向走。一致性模型(consistency model)的作用是把轨迹上任意点一步映射回清晰端,天然得到单步推理;Kernel ControlNet 显式估计模糊核作为条件,让轨迹知道"糊成什么样"。设计上最关键的对比是它与 DeblurDiff/OSDD 的立场对立——后者接受"扩散=感知强但 PSNR 低",FideDiff 用"模糊轨迹 + 一致性"论证扩散也能做到 28.79 dB 的高保真。同作者群(又是 Yulun Zhang 组,与 OSDD 同一 xyLiu339),可视为该组从"感知优先"转向"保真优先"的路线修正。遗憾同样是代码未放,28.79 这个数字目前只能采信论文表格。
2.4 BlurDM —— 双扩散:把模糊和噪声一起扩上去,做即插即用先验
BlurDM (NeurIPS 2025, arxiv:2512.03979) — ✅ verified
- 核心贡献:观察到运动模糊源于连续曝光,用双扩散前向(dual-diffusion)把噪声与模糊同时扩加到清晰图上,反向推导出"边去噪边去模糊"的联合公式;做成隐空间即插即用先验,增强现有去模糊网络而非替换。
- 方法:dual-diffusion forward(noise + blur 双通道扩散)→ reverse 联合 denoise+deblur;在隐空间作为 prior generation network 挂到骨干上。
- 关键结果:作为插件稳定提升四个骨干——MIMO-UNet +0.59 dB、Stripformer +0.75 dB、FFTformer +0.25 dB、LoFormer +0.51 dB(GoPro);RealBlur-J 上增益更大(+0.78 dB);LoFormer 某数据集最高 +1.24 dB。
- 代码:github.com/Jin-Ting-He/BlurDM(MIT,~20★,train_stage1/2/3.py + deblur_predict.py 脚本齐全,权重 coming soon)。
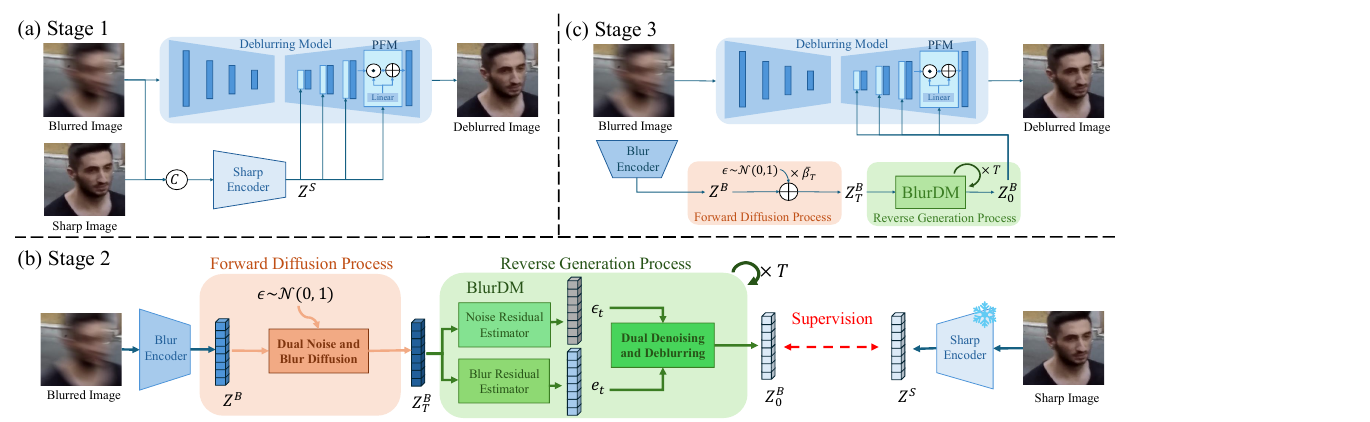
Z^S;阶段 2 训练 BlurDM——模糊隐码经"双噪声+模糊扩散"前向、再由 Noise Residual 与 Blur Residual 两个估计器反向做"双去噪+去模糊",监督到 Z^S;阶段 3 联合微调,BlurDM 作为插件先验注入去模糊网络。图中双残差分支正是"噪声+模糊同时扩散"的落点。(论文 Fig. 2)怎么做的:BlurDM 与 FideDiff 撞了同一个直觉——把模糊纳入扩散过程——但落点不同。FideDiff 用单一模糊轨迹取代噪声轨迹;BlurDM 保留噪声、再叠一路模糊扩散(双扩散),forward 时清晰图同时被高斯噪声和模糊污染,reverse 时同一个网络既要去噪又要去模糊。更重要的定位差异:BlurDM 不是端到端复原器,而是先验插件——它在隐空间生成一个"模糊感知先验",挂到 MIMO-UNet / Stripformer / FFTformer / LoFormer 这些现成回归骨干上去涨点。这解释了它的结果为什么是"+0.x dB 的普涨"而非绝对 SOTA 数字:它的价值主张是正交增益(任何骨干都能 +0.25~0.78 dB),而非单独夺榜。设计取舍——插件式意味着它不与骨干争夺"谁是复原器",落地阻力小;但也意味着它离不开一个好骨干,单独不成篇。仓库有完整三阶段训练脚本,是本调研里代码可跑性最高的几个之一(仅缺预训练权重)。
2.5 TP-Diff —— 非配对数据上学去模糊纹理先验,扩散首次进非配对复原
TP-Diff (ICCV 2025, arxiv:2507.13599) — ✅ verified
- 核心贡献:首个把扩散用于非配对(unpaired)去模糊的工作——用扩散模型学一个空变纹理先验,无需成对的模糊/清晰监督。
- 方法:纹理先验编码器 TPE(带 memory 机制,在隐空间编码模糊图纹理先验)+ 纹理迁移 Transformer TTformer(内含滤波调制多头自注意力 FM-MSA,自适应滤除空变模糊)+ 小波域对抗损失(保高频纹理)。
- 关键结果:论文称在常用基准上超越 SOTA(摘要未给具体数字,本调研未能核到逐项表格)。
- 代码:github.com/ChengxuLiu/TP-Diff(代码存在:models/ + ldm/ + train_S1.py/train_S2.py/test.py 两阶段脚本,~11★)。
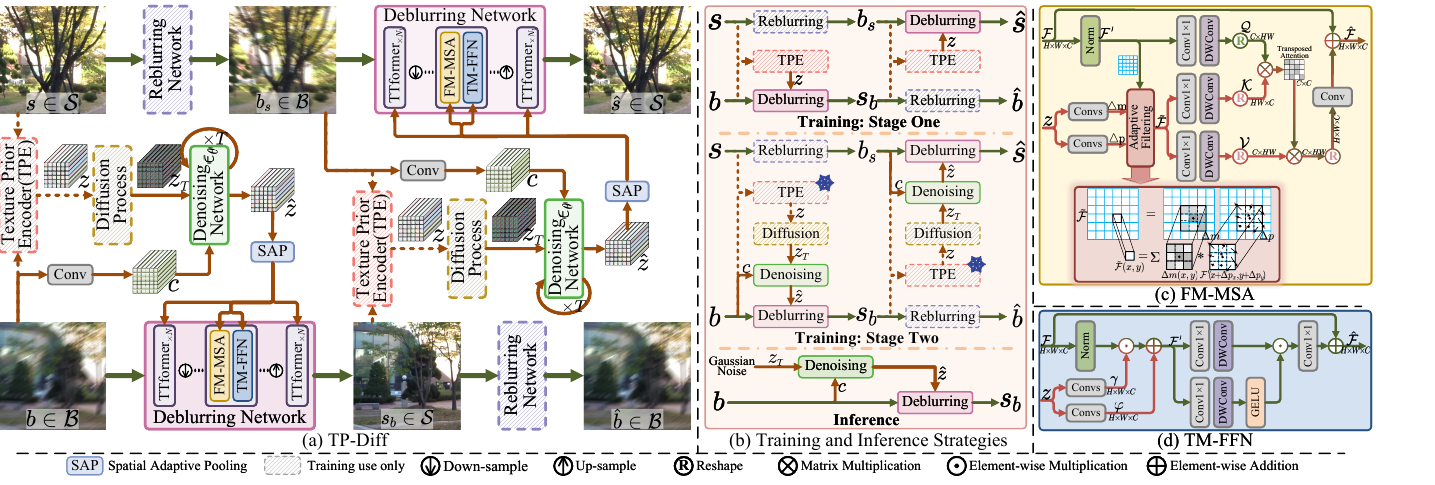
z,经 SAP 注入去模糊网络的 TTformer 层;(c)(d) 为 TTformer 内的 FM-MSA(滤波调制多头自注意力)与 TM-FFN。循环结构正是它摆脱成对监督的关键。(论文 Fig. 2)怎么做的:前面几篇都吃成对监督(GoPro 这类合成配对或 RealBlur 这类采配对)。TP-Diff 的立场是——真实场景很难拿到严格配对的模糊/清晰图,所以走非配对。核心是用扩散模型生成纹理先验知识辅助恢复模糊图的纹理:TPE 用 memory 机制把清晰图的纹理表示存下来监督扩散训练,TTformer 里的 FM-MSA 通过自适应滤波处理空变模糊(不同位置模糊核不同,用调制滤波器逐位置对付),小波对抗损失专门盯高频细节别糊掉。设计上它和 DeblurDiff 都要对付"空变模糊",但手段不同:DeblurDiff 显式预测逐像素卷积核(LKPN/EAC),TP-Diff 用注意力里的滤波调制隐式处理。非配对是它最大的差异化,也是最大的风险点——非配对复原通常保真度不稳,能否在真实模糊上稳定超越配对法,需要代码复现验证。
2.6 DeblurFlow —— 流匹配残差重参数化,把噪声端点换成模糊观测
DeblurFlow / Restoration-Aligned Generative Flow (arxiv:2605.08854, 2026-05) — ✅ verified
- 核心贡献:流匹配路线——把 flow 轨迹的噪声端点直接换成模糊观测,使向量场恰好等于"模糊图−清晰图"的残差,标准 flow matching loss 自然退化为残差 loss,从而能用 LoRA 微调预训练流模型来做复原对齐。
- 方法:残差流重参数化 + LoRA 适配 + r-space(专为残差解码设计的隐空间,比标准 VAE 解码省最多 9×)+ 双专家采样(保真专家 + 感知专家)。
- 关键结果:双专家——保真专家 PSNR 33.69 dB 做高保真初始化,DeblurFlow 感知增强后 33.05 dB(仅轻微降保真),远超"直接套生成模型"的 27.60 dB。数据集 GoPro / HIDE / RealBlur / RWBI。
- 代码:⚠️ 未找到公开仓库(截至本次调研)。
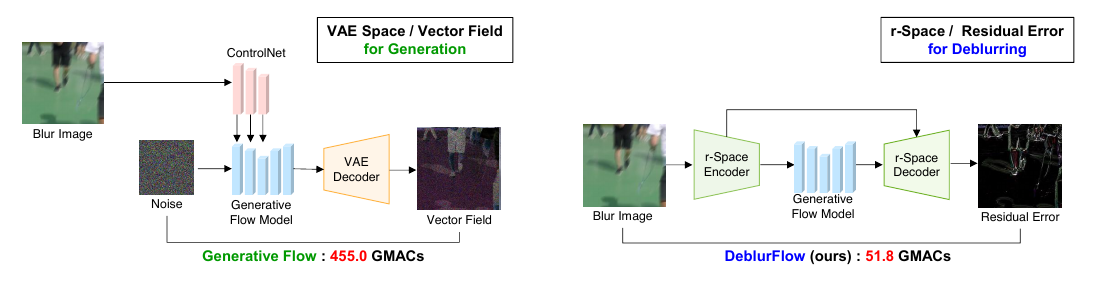
怎么做的:这是本调研里唯一的纯流匹配(flow matching)去模糊工作,也是最新(2026-05)。标准流匹配从噪声流向数据,端点(噪声)与去模糊任务无关;DeblurFlow 把起点端换成模糊观测,于是从模糊流向清晰,向量场 = 残差(模糊−清晰)。这个重参数化有个漂亮副产品:flow matching 的回归 loss 直接变成残差回归,语义上就是"预测模糊图要减掉多少",因此能用 LoRA 轻量微调一个预训练流模型(不用从头训)。r-space 是第二个巧思——既然只需解码残差而非重建整图,就设计一个更省的残差隐空间,把 VAE 编解码开销砍到最多 1/9。双专家采样把保真与感知解耦成两个模型:一个 33.69 dB 打底,一个在其上做感知增强只掉 0.6 dB——这与 OSDD 的 DDA(单模型内部动态加权)是同一目标的不同实现。理念上 DeblurFlow 与 FideDiff 殊途同归(都把生成端点从"噪声"改成"模糊/残差"),区别是 FideDiff 走扩散+一致性、DeblurFlow 走流匹配+残差场。无代码是最大短板,33.69 这个数字待验。
2.7 DeblurSDI —— 零样本自扩散,联合估清晰图与模糊核,无需任何预训练
DeblurSDI / Self-Diffusion Driven Blind Imaging (arxiv:2510.27439, 2025-10) — ✅ verified
- 核心贡献:零样本、自监督盲复原——用"自扩散(self-diffusion)"从纯噪声出发迭代反向优化,联合估计清晰图与模糊核(PSF),完全不需要外部数据预训练。
- 方法:反向自扩散过程中,两个随机初始化网络分别拟合清晰图与模糊核,目标 = 数据一致性 + 核的 ℓ1 稀疏先验;面向"光学像差 + 运动模糊"的组合退化。
- 关键结果:论文称在盲反卷积上大幅超越现有方法(摘要未给具体基准数字)。
- 代码:github.com/ggluo/Self-Diffusion(MIT,
sdi.py为自扩散主实现,含 MRI/通用反问题的 run 脚本)。
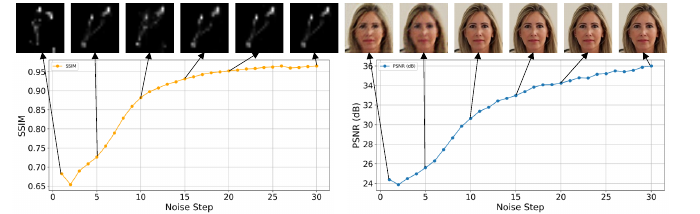
怎么做的:与前六篇根本不同——它不训练任何数据集,是一个 per-image 的测试时优化框架(精神上接近 Deep Image Prior 的盲复原版)。给一张模糊图,DeblurSDI 从纯噪声起步,用反向自扩散逐步精化两样东西:清晰图 x 和模糊核 k,两个随机初始化的网络分别参数化它们,优化目标是数据一致性(blur(x)⊛k ≈ y)加上模糊核的 ℓ1 稀疏(真实运动核确实稀疏)。"自扩散"指的是它借用扩散的从-噪声-精化的迭代结构,但噪声/退化都来自图像自身,不需要在外部大数据上学先验。设计取舍很清楚:零样本 = 极强泛化(对光学像差+运动模糊的组合退化尤其有用,这类退化难以合成配对数据),代价是每张图都要跑一轮优化,慢,且盲估计的病态性使其对超参和初始化敏感。它填的是与 DeblurDiff/FideDiff 完全不同的生态位:后者要大数据训练、推理快;DeblurSDI 无需数据、推理慢,适合数据稀缺的科学成像。
2.8 相邻工作(收录但非核心)
- ELIR (arxiv:2502.03500, 2025-02) ✅ — 潜一致性流匹配(latent consistency flow matching,LCFM),模型比 SOTA 扩散/流方法小 4×、快 4×,主打盲人脸复原与边缘部署;去模糊非其主线,故列为相邻。代码:github.com/eladc-git/ELIR(CC BY 4.0)。
- RealVDeblur (arxiv:2607.20628, 2026-07) ✅ — 视频去模糊,一步扩散 + 基于 3DGS 的物理模糊合成管线提升真实域泛化;本调研聚焦单图像,故仅提及。
- Restora-Flow (arxiv:2511.20152, 2025-11) ✅ — 训练无关的掩码引导流匹配复原,覆盖 inpainting/SR/denoise,去模糊为附带任务,非专门去模糊方法。
3. 人脸去模糊 / 盲人脸复原
框架说明(先厘清口径):扩散时代的"人脸去模糊"几乎不作为独立任务存在,而是被盲人脸复原(Blind Face Restoration, BFR)吸收——真实低清人脸同时含模糊、噪声、下采样、JPEG 压缩等混合退化,模糊只是其中一维,单独去模糊没有实用意义。所以下列人脸方法都是 BFR 框架,去模糊是其复原能力的一部分;它们与 §2 通用去模糊的根本差异在于:人脸有极强的结构先验(五官布局、身份),因此 BFR 的主战场不是"去多少糊"而是身份保持(identity preservation)与真实感 vs 幻觉(模型会不会编造出一张不是本人的清晰脸)。这也解释了为什么这些工作几乎都围绕"身份编码器 / 参考人脸 / 反幻觉"设计,而非围绕模糊核。与 §2.8 的 ELIR(潜一致性流匹配 BFR)同属此域。
3.1 FaceMe —— 身份编码器把参考人脸变成扩散提示,免微调换身份
FaceMe (AAAI 2025, arxiv:2501.05177) — ✅ verified
- 核心贡献:把身份特征当作扩散提示——用身份编码器从一张/几张参考人脸抽身份嵌入,替换文本提示里的 face token,引导扩散复原出身份一致的高清脸,且推理期换身份无需重训。
- 方法:身份编码器(ArcFace + CLIP 图像编码器)抽身份特征 → 替换 CLIP 提示 "a photo of face" 的 face token → 条件化冻结扩散 UNet 的交叉注意力;可训练 ControlNet 注入低清输入做空间控制。
- 关键结果:支持任意数量参考图输入;换身份免微调。论文报在合成与真实 BFR 基准上身份一致性优于同类(具体逐项数字本调研未核到表格)。
- 代码:github.com/modyu-liu/FaceMe(train/infer/demo 脚本齐全,权重列 TODO,~55★,Pi-Lab License)。
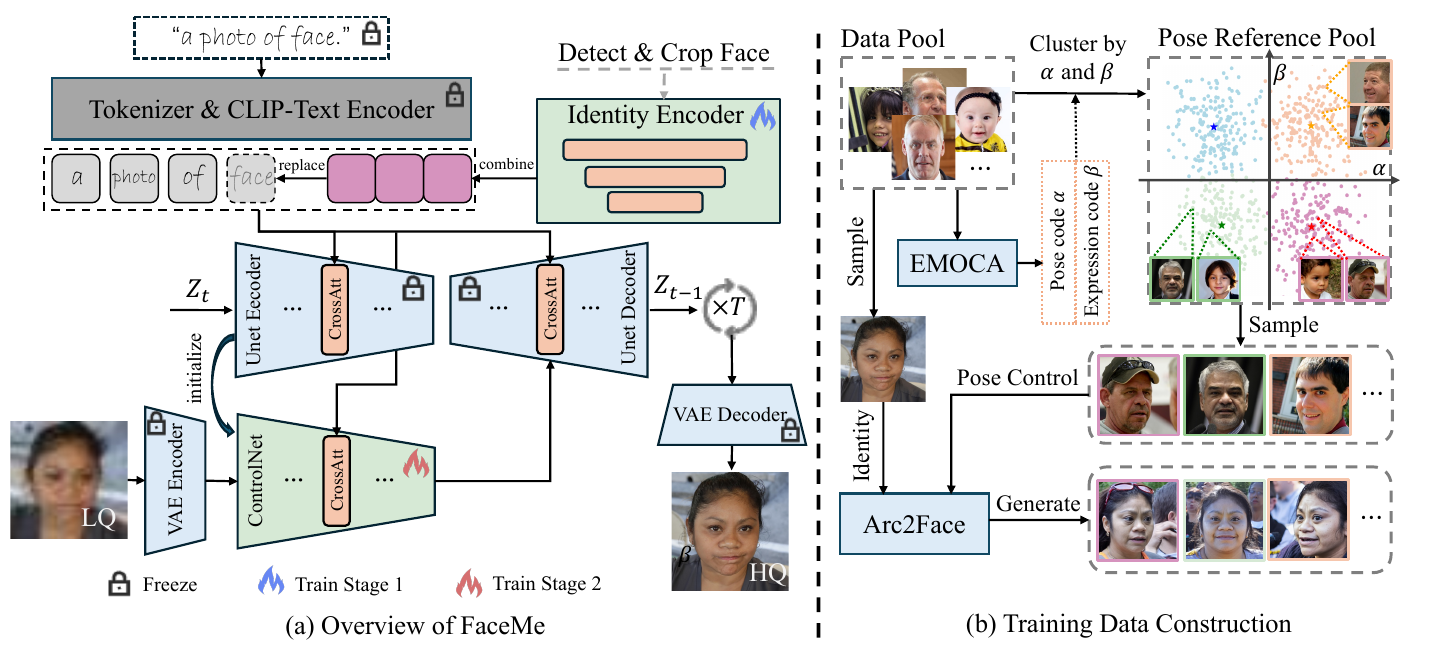
怎么做的:BFR 的老问题是——低清脸信息太少,扩散会"脑补"出一张好看但不是本人的脸。FaceMe 的解法是给扩散一个身份锚点:用 ArcFace(人脸识别网络,身份判别性强)+ CLIP(语义丰富)双编码器从参考人脸抽身份嵌入,然后不是把它当额外条件塞进去,而是替换文本提示里 "face" 这个词的 embedding——相当于告诉 SD"画的不是随便一张脸,是这个身份的脸",直接作用在交叉注意力上。低清输入的空间结构(姿态、表情、位置)则由一个可训练 ControlNet 注入。关键设计取舍:身份走提示、结构走 ControlNet 的解耦,使得推理期换一个人只需换参考图重算身份嵌入,不用重训模型(对比早期需要 per-identity 微调的个性化方法,这是实用性的关键)。训练数据侧还构造了一个模拟姿态/表情的参考池,避免模型把"参考图的表情"误当身份。它与 §2 方法的分界很清楚:DeblurDiff 们对付"糊",FaceMe 对付"这还是不是他"。
3.2 HonestFace —— 一步扩散 + 反幻觉,让复原"诚实"不编脸
HonestFace (arxiv:2505.18469, 2025-05) — ✅ verified
- 核心贡献:主打**"诚实"复原**——一步扩散做 BFR,同时用身份嵌入 + 掩码人脸对齐压制"编造五官/合成纹理"的幻觉,让输出忠于低清输入的真实身份与纹理。
- 方法:一步扩散 UNet + 身份嵌入器(从 LQ 输入 + 参考人脸抽
p_F/p_I)+ 掩码人脸对齐L_MFA(增纹理真实感、防合成伪影)+ landmark 评价指标;判别器 +L_ID/L_Per对抗训练。 - 关键结果:论文称视觉质量与量化指标均超 SOTA(具体数字本调研未核到表格)。
- 代码:github.com/jkwang28/HonestFace(⚠️ 声明将公开,本调研核查时以占位/待放为主,CC BY 4.0)。与 OSDD/FideDiff 同属 Yulun Zhang 组。
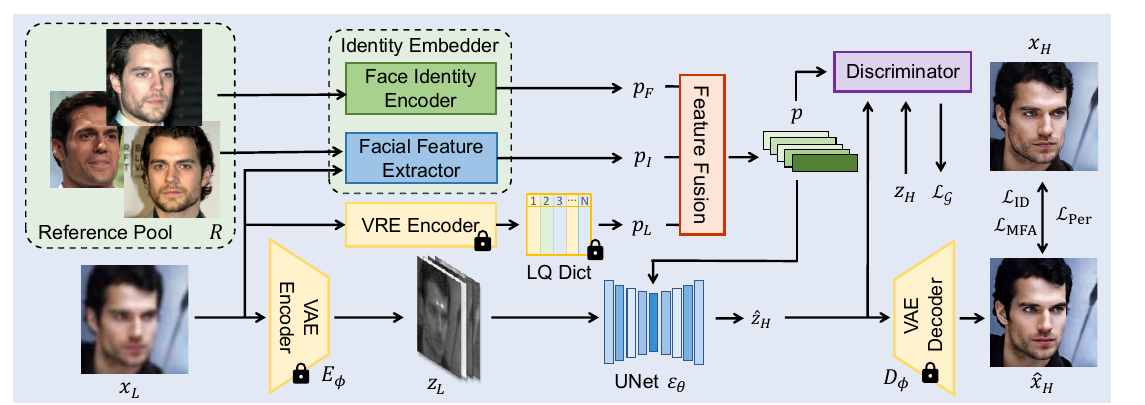
x_L 编码为 z_L;x_L + 参考池人脸经身份嵌入器(人脸身份编码器 + 面部特征提取器)与 VRE 编码器得 p_F/p_I/p_L,融合成提示 p 条件化 UNet,一步预测 HQ 隐码 ẑ_H;判别器 + L_ID/L_MFA(掩码人脸对齐)/L_Per 驱动"诚实"训练。(论文 Fig. 1)怎么做的:HonestFace 与 FaceMe 是同域近邻,但落点在"别编脸"。它同样用身份嵌入锚定身份,区别有二:一是一步扩散(承接 Yulun Zhang 组在 OSDD/FideDiff 上的一步化路线,把 BFR 也压到单步),二是专门设计**掩码人脸对齐损失 L_MFA**对付幻觉——BFR 的真实感陷阱是模型倾向生成"平均意义上好看"的皮肤/毛发纹理,看着清晰但其实是编的;L_MFA 在人脸区域做掩码对齐,逼输出纹理贴合输入而非凭空合成。它还提出基于 landmark 仿射的评价指标,因为传统 PSNR/LPIPS 抓不住"五官有没有被挪位/篡改"。设计取舍很清晰:一步化换速度、掩码对齐换"诚实"、身份嵌入换身份保持——三者都是冲着 BFR 的"高感知但可能失真失身份"这一软肋。代码尚以占位为主,数字待复现。
3.3 AuthFace —— 面向人脸微调 T2I 先验 + 8K 高质数据,两阶段做真实复原
AuthFace (ACM MM 2025 Oral, arxiv:2410.09864 [2024-10 arxiv]) — ✅ verified [arxiv 2024-10,会议 2025]
- 核心贡献:指出直接套 T2I 扩散做 BFR 会生成错误的非人脸细节,提出面向人脸的生成扩散先验——用一批 8K 超高清专业人像(AuthFace-HQ)+ 面向人脸的 restoration-tuning 管线微调 T2I,再接 ControlNet 做复原。
- 方法:两阶段——阶段 I 面向人脸微调 SDXL UNet(人脸掩码加权 L2 + 负向引导);阶段 II 冻结该 UNet、训 ControlNet 适配低清输入,眼/嘴区域用时间感知判别器监督。
- 关键结果:AuthFace-HQ 数据集(约 2100 张 8K+ 专业人像,含 Qwen caption)+ 更真实的五官细节;论文称优于现有 BFR(具体数字本调研未核到表格)。
- 代码:github.com/EthanLiang99/AuthFace(✅ 代码 + 权重 + AuthFace-HQ 数据集均已释放,~18★,Apache-2.0;数据非商用)。
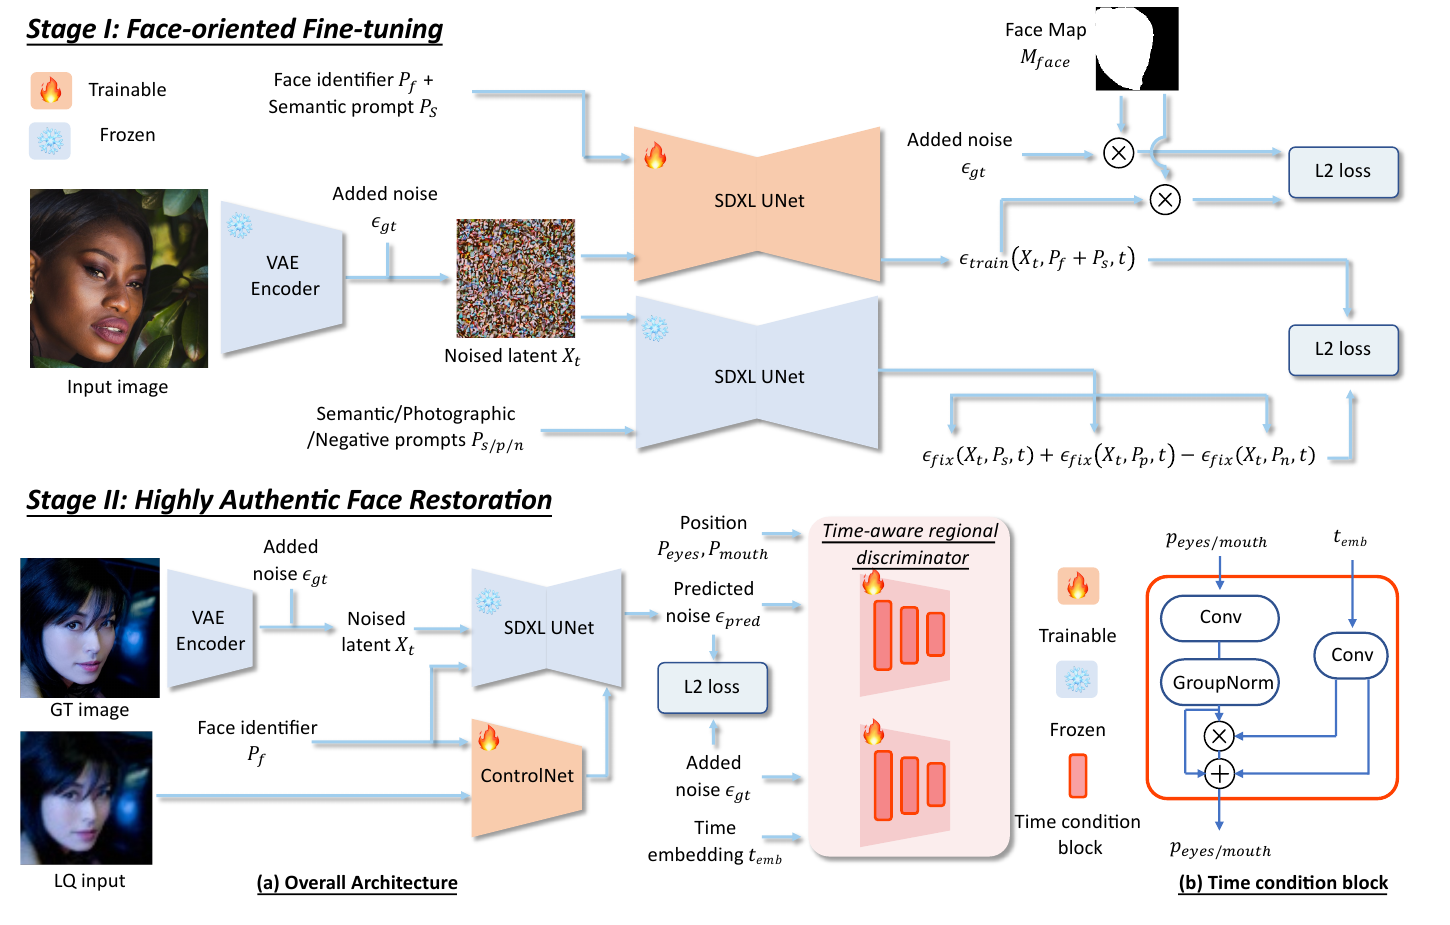
怎么做的:AuthFace 诊断的病是——通用 T2I(SD/SDXL)的先验里人脸只是万千概念之一,直接拿来复原会长出"看着像脸但细节是错的"东西(歪的牙齿、糊的虹膜)。它的解法不是改结构而是改先验来源:先用一批专业摄影师拍的 8K+ 超高清人像(自建 AuthFace-HQ)把 SDXL 的先验面向人脸重塑一遍(阶段 I,人脸掩码加权让损失聚焦五官、负向引导抑制非人脸幻觉),得到一个"更懂人脸"的生成先验;再冻结它、只训 ControlNet 把低清输入接进来(阶段 II),并对眼睛和嘴这两个最影响真实感与身份的区域上时间感知判别器精修。设计取舍:数据驱动的先验重塑成本高(要采 8K 数据)但换来五官保真,且代码+权重+数据全开源是本节落地性最好的一个。它和 HonestFace 是对"BFR 幻觉"的两种答卷——HonestFace 用损失约束、AuthFace 用高质先验+区域判别。
3.4 LAFR 与流匹配路线(ELIR)
LAFR (arxiv:2505.23462, 2025-05) — ✅ verified
- 核心贡献:高效 BFR——用码本式潜空间对齐适配器(latent codebook alignment adapter)把低清图的隐分布对齐到高清分布,无需重训 VAE,即可轻量迁移预训练 SD 先验。
- 方法:codebook-based latent space adapter 对齐 LQ↔HQ 隐分布;仅用 0.9% 的 FFHQ 轻量微调、训练时间降 70%。
- 关键结果:以极小训练代价达到与 SOTA 相当的复原质量;解决 SD 的 VAE 只在高清上训、编码低清时语义错位的问题。
- 代码:本调研未在检索中确认公开仓库(OpenReview 页 存在;代码状态标
[未确认])。
怎么做的(简):LAFR 针对的是"SD 的 VAE 只见过高清、一编码低清就语义漂移"这个 BFR 通病。它不动 VAE,而是插一个码本对齐适配器把低清隐码"翻译"到高清隐分布邻域,于是下游冻结 SD 能正常吃这个条件。价值主张是效率——0.9% FFHQ + 少参数微调、省 70% 训练时间,属于把 BFR 往轻量/可复现方向推。它与 §2 的 DeblurDiff 撞同一个"VAE 编低清会塌"的问题,但 DeblurDiff 用 LKPN 预测核对齐特征,LAFR 用码本对齐隐分布——同病、异解,是一组有意思的对照。
流匹配路线:本节的流匹配代表是已在 §2.8 列出的 ELIR(潜一致性流匹配 LCFM,模型小 4×/快 4×,主打 BFR + 边缘部署,github.com/eladc-git/ELIR)。与通用去模糊侧的 DeblurFlow 呼应——人脸域的流匹配同样刚起步、且同样押注一步/少步化与轻量部署,是明确白地。
4. 平行对比
| 方法 | 年份/会议 | 生成范式 | 端点重构 | 核/退化处理 | 监督 | 步数 | 代码状态 | 头部结果(数据集) |
|---|---|---|---|---|---|---|---|---|
| DeblurDiff | 2025 NeurIPS | 微调预训练 SD(先验) | 否(标准噪声) | LKPN 预测逐像素空变核 + EAC | 配对 | 多步 | ✅ 脚本+权重 | LPIPS 0.219 (GoPro),PSNR 低 |
| OSDD | 2025-03 | 微调预训练 SD(一步蒸馏) | 否 | eVAE 补保真 + DDA | 配对 | 1 步 | ⚠️ 占位/未放 | LPIPS 0.121 / 0.88s (GoPro) |
| FideDiff | 2026 ICLR | 从头/一致性模型 | ✅ 模糊即轨迹 | Kernel ControlNet 估核 | 配对 | 1 步 | ⚠️ 占位/未放 | PSNR 28.79 (GoPro) |
| BlurDM | 2025 NeurIPS | 从头双扩散(插件先验) | ✅ 噪声+模糊双扩散 | 隐式建模模糊形成 | 配对 | 多步 | ✅ 脚本(缺权重) | 插件普涨 +0.25~0.78 dB |
| TP-Diff | 2025 ICCV | 扩散先验(非配对) | 否 | FM-MSA 滤波调制 | 非配对 | 多步 | ✅ 脚本 | 称超 SOTA(数字未核到) |
| DeblurFlow | 2026-05 | 流匹配 + LoRA | ✅ 残差场(换成模糊观测) | 隐式(r-space 残差解码) | 配对 | 少步(双专家) | ❌ 无 | PSNR 33.69(保真专家) |
| DeblurSDI | 2025-10 | 零样本自扩散 | —(测试时优化) | 联合估 PSF + ℓ1 稀疏 | 零样本/自监督 | 迭代优化 | ✅ 脚本 | 称大幅超盲反卷积 |
说明:PSNR 列不可横向直接比——DeblurDiff/OSDD 走 SD 隐空间,PSNR 天然低(VAE 损失);FideDiff/DeblurFlow 在像素/残差域,PSNR 高。且各家 eval 协议不同(OSDD 用 γ=0.7 gamma 校正、DeblurFlow 报"保真专家"而非端到端)。详见 §5 矛盾分析。
人脸去模糊 / 盲人脸复原(§3)单列对比——轴与通用去模糊不同,判别维度是身份保持与反幻觉手段,而非模糊核处理:
| 方法 | 年份/会议 | 生成范式 | 身份保持机制 | 反幻觉/真实感手段 | 步数 | 代码状态 |
|---|---|---|---|---|---|---|
| FaceMe | 2025 AAAI | 冻结 SD + ControlNet | 身份嵌入替换 face token(ArcFace+CLIP) | 参考图训练池 | 多步 | ✅ 脚本(缺权重) |
| HonestFace | 2025-05 | 一步扩散 | 身份嵌入器(LQ+参考) | 掩码人脸对齐 L_MFA + landmark 度量 | 1 步 | ⚠️ 占位/待放 |
| AuthFace | 2025 ACM MM Oral | 面向人脸微调 SDXL + ControlNet | 8K 高质人脸先验 | 眼/嘴时间感知判别器 | 多步 | ✅ 代码+权重+数据 |
| LAFR | 2025-05 | 冻结 SD + 码本适配器 | 码本对齐 LQ↔HQ 隐分布 | —(主打效率) | 多步 | [未确认] |
| ELIR | 2025-02 | 潜一致性流匹配 | —(通用 BFR) | 轻量/边缘部署 | 少步 | ✅ 代码 |
5. 一致与矛盾
一致(独立工作的收敛信号)
- 端点重构是 2025→2026 的共识转向。三个独立团队——FideDiff(模糊轨迹)、BlurDM(噪声+模糊双扩散)、DeblurFlow(残差场换掉噪声端点)——不约而同地把扩散/流的端点从"纯噪声"改成"模糊/残差"。这是强信号:领域已认定"从与任务无关的噪声幻觉出发"是 SD-先验路线保真度低的病根,正确做法是让生成轨迹物理对齐去模糊。
- 一步/少步化是硬需求。OSDD、FideDiff(consistency)、DeblurFlow(r-space+双专家)、ELIR(LCFM)都在压步数。多步扩散去模糊在 2026 已被普遍视为不可落地,与diffusion-sr-2026里超分的一步化浪潮完全同步。
- 隐空间操作近乎标配。DeblurDiff、OSDD、BlurDM、FideDiff、DeblurFlow(r-space)都在隐空间跑,为算力;纯像素域只剩零样本的 DeblurSDI(它本就不追求速度)。
- 空变模糊被认真对待。DeblurDiff(逐像素核 EAC)、TP-Diff(FM-MSA 滤波调制)、DeblurSDI(联合估 PSF)都显式处理"模糊核随位置变",而非假设均匀模糊。
- 人脸域的共识是"身份 + 反幻觉",而非模糊核(§3)。FaceMe(身份嵌入替 token)、HonestFace(身份嵌入器 + 掩码对齐)、AuthFace(高质人脸先验 + 区域判别)三家独立工作都把火力集中在身份保持与抑制幻觉上,几乎不谈模糊核——印证了"人脸去模糊在扩散时代被 BFR 吸收、主要矛盾从去糊转成保身份"。且一步化/轻量化的浪潮(HonestFace 一步、LAFR 省 70% 训练、ELIR 小 4×)与通用去模糊侧完全同频。
矛盾(需要指名点出的冲突)
- 保真 vs 感知,扩散去模糊到底能不能高 PSNR? DeblurDiff 明确接受"扩散=感知强、PSNR 低"(GoPro PSNR ~24.32,还在论文里承认 HI-Diff 的 33.33 更高),只报无参考指标;OSDD 干脆不报 PSNR/SSIM。而 FideDiff 正面反驳——用"模糊轨迹+一致性"打出 GoPro 单步 PSNR 28.79,主张扩散也能高保真。这是本领域最实质的立场冲突:同一作者群(Yulun Zhang 组)在 OSDD→FideDiff 间自我路线修正,从感知优先转向保真优先。
- PSNR 数字不可比,暗藏测量口径分歧。FideDiff 报 GoPro 28.79、DeblurFlow 报 33.69、回归法 HI-Diff 33.33、DeblurDiff ~24。这些不在同一测量协议下:DeblurDiff/OSDD 走 SD 隐空间(VAE 天花板压低 PSNR),FideDiff 在像素域一致性,DeblurFlow 的 33.69 是"保真专家"而非其感知模型端到端结果(感知模型 33.05)。把它们并列成排行榜会误导——同为"扩散去模糊 SOTA"的宣称,度量的根本不是同一件事。
- 基线数字各家报得不一致。FideDiff 表里 OSEDiff 在 RealBlur 只有 PSNR 24.34、DiffBIR 26.15;但这些方法原本为超分/通用复原设计,被搬到去模糊 benchmark 上重测,跨论文引用同一基线常出现不同数字(不同 retrain、不同测试子集)。引用这些对比数时需回到各自论文的测量条件。
- 配对 vs 非配对 vs 零样本,监督假设不兼容。DeblurDiff/OSDD/FideDiff/BlurDM 吃成对监督;TP-Diff 走非配对;DeblurSDI 零样本无训练。三者的"SOTA"宣称建立在不同数据可得性假设上,不能直接比高低——非配对/零样本牺牲绝对指标换泛化与免数据,属不同生态位。
- 人脸"真实感"本身就是双刃,且各家未对齐评价(§3)。BFR 追求真实清晰的脸,但"清晰"可能以篡改身份/编造五官为代价——HonestFace 专门指出传统 PSNR/LPIPS 抓不住五官被挪位,另提 landmark 度量;AuthFace 指出直接套 T2I 会长出错误非人脸细节。这与通用去模糊的"保真 vs 感知"之争同构,但人脸多一层身份真伪维度,且各家用的身份/真实感指标互不相同,横向比"谁更真"目前无统一标尺——与 §7 呼吁的统一 benchmark 是同一个洞。
6. 代码交叉验证
对有真实仓库的方法,逐一打开核心函数确认与论文主张一致(未打开的明确标注):
- ✅ DeblurDiff 的 EAC 确为空变卷积。
model/lkpn.py里IDynamicConv模块 +_idynamic_cudaCUDA 核实现逐像素卷积:权重张量 reshape 成(B, C//(kH·kW), kH, kW, H, W)——核维度带 (H,W),即每个空间位置一套独立核;CUDA 前向value += weight_data[offset_weight] * bottom_data[offset]用位置相关的offset_weight取权重。与论文"element-wise adaptive convolution 施加空变核"完全对应。主张属实。 - ✅ BlurDM 是可跑的插件式训练框架。github.com/Jin-Ting-He/BlurDM 含
train_stage1/2/3.py+deblur_predict.py+eval_metrics.py,src/下有MIMO_UNet/、Stripformer/骨干目录——与论文"作为先验插件增强 MIMO-UNet/Stripformer 等骨干"的定位一致(三阶段=先验预训练→骨干集成→联合微调)。⚠️ 未逐行打开 dual-diffusion 前向函数确认"噪声+模糊双扩散"的加噪公式(src/下未见单独 diffusion 文件名,核心逻辑分散在骨干目录),此点为结构级验证,非公式级。权重 coming soon。 - ✅ DeblurSDI 主实现为
sdi.py。github.com/ggluo/Self-Diffusion 的sdi.py是自扩散算法主体,配run_*.sh覆盖 MRI 等多种反问题——与"通用自监督反问题框架、去模糊为其一"的定位一致。⚠️ README 偏通用反问题,未单列去模糊的 ℓ1 核稀疏项代码位置,为仓库级验证。 - ✅ TP-Diff 代码存在(非占位):
models/+ldm/+train_S1.py/train_S2.py/test.py两阶段脚本齐全,与"TPE 纹理先验(阶段1)+ TTformer 去模糊(阶段2)"两段式一致。⚠️ 未逐行确认 FM-MSA 实现。 - ⚠️ OSDD、FideDiff 为占位仓库:OSDD README 明写 "Release code and pretrained models" 为 TODO,仅有 assets 图;FideDiff 2026-06 只放了可视化结果,无 .py 实现。其论文数字(OSDD LPIPS 0.121、FideDiff PSNR 28.79)目前无法代码复现,只能采信论文表格——这是引用时必须带的 caveat。
- ❌ DeblurFlow 无公开仓库:33.69 dB 待代码释放后验证。
人脸域(§3):
- ✅ AuthFace 全开源:github.com/EthanLiang99/AuthFace 含
test_face_xl.py+models/+pipelines/+ 已释放权重与 AuthFace-HQ 数据集,与"两阶段面向人脸微调 + ControlNet"定位一致(2026-01 放码、2025-10 放数据)。⚠️ 未逐行打开阶段 I 的人脸掩码加权损失函数,为仓库级验证。 - ✅ FaceMe 脚本齐全:github.com/modyu-liu/FaceMe 有
train.py/infer.py/demo.py,utils/preprocess.py提取 ArcFace+CLIP 身份嵌入——与"身份编码器抽嵌入当提示"一致;⚠️ 权重列 TODO,未逐行确认 token 替换实现。 - ⚠️ HonestFace 以占位/待放为主、LAFR 未确认公开仓库:二者头部数字目前无法代码复现,引用需带 caveat。
代码可跑性排序(有权重/可复现优先):DeblurDiff(脚本+权重)≈ AuthFace(脚本+权重+数据,人脸域最完整) > BlurDM ≈ TP-Diff ≈ DeblurSDI ≈ FaceMe(脚本,缺权重或需 per-image 优化)> OSDD ≈ FideDiff ≈ HonestFace(占位)> DeblurFlow ≈ LAFR(无/未确认)。
7. 启发与白地
- "改端点"已被证明有效,但流匹配路线几乎空白。把生成端点从噪声改成模糊/残差,FideDiff(扩散+一致性)和 DeblurFlow(流匹配+残差)都验证了其价值,但流匹配去模糊全领域只有 DeblurFlow 一篇、且无代码。相比超分领域流匹配已相当拥挤(参见diffusion-sr-2026),去模糊的流匹配是明确白地——残差重参数化 + LoRA 的低成本适配尤其值得复现推广。
- "论文很强但代码是占位"是本领域的系统性风险。两篇立场最鲜明的高保真工作(OSDD、FideDiff)都是占位仓库,头部数字(尤其 FideDiff 的 28.79 dB "扩散追平回归")无第三方复现。想在这条线上做实验,当前唯一有权重可跑的是 DeblurDiff;BlurDM/TP-Diff/DeblurSDI 有脚本但需自训。选型建议:要立刻能跑→DeblurDiff;要插件涨点→BlurDM;要免数据/科学成像→DeblurSDI。
- 保真-感知之争尚未收敛,度量口径亟需统一。同称 SOTA 的方法度量的根本不是一回事(隐空间 vs 像素域、保真专家 vs 端到端、γ 校正与否)。领域缺一个统一协议的扩散去模糊 benchmark——这本身是高价值的工程贡献白地。
- 散焦去模糊被扩散冷落。运动去模糊拥挤,散焦(defocus)扩散去模糊 2025 仅零星(一篇 Nature Sci. Rep. score-based、一篇 ICASSP 效率网络),空间大。
- 零样本盲估计 + 学习先验的融合。DeblurSDI(零样本联合估 PSF)与 FideDiff(学习式 Kernel ControlNet)代表两极;把"per-image 自扩散优化核"与"预训练核先验"结合(用学习先验初始化零样本优化)是一条尚未有人走通的路。
- 人脸域:流匹配几乎空白,身份-真实感缺统一标尺(§3)。人脸 BFR 的流匹配代表只有 ELIR 一篇(潜一致性流匹配),与通用侧 DeblurFlow 一样刚起步——人脸域的残差流/一步流匹配是明确白地。另一处白地是评价:各家自定义身份/真实感指标(HonestFace 的 landmark 度量、AuthFace 的区域判别),缺一个同时量化"去糊程度 + 身份保真 + 反幻觉"的统一 BFR benchmark。此外,通用去模糊的"改端点"思想(把噪声端点换成模糊/残差,见 §2 的 FideDiff/BlurDM/DeblurFlow)尚未被搬到人脸域——人脸 BFR 目前仍以"冻结 SD + 身份条件"为主,若把端点重构进 BFR 或许能同时缓解保真与幻觉,是一条可迁移的路。
8. 参考文献
- DeblurDiff: Real-World Image Deblurring with Generative Diffusion Models — arxiv 2502.03810(NeurIPS 2025)· 代码 github.com/kkkls/DeblurDiff
- One-Step Diffusion Model for Image Motion-Deblurring (OSDD) — arxiv 2503.06537(2025-03)· 代码(占位)github.com/xyLiu339/OSDD
- FideDiff: Efficient Diffusion Model for High-Fidelity Image Motion Deblurring — arxiv 2510.01641(ICLR 2026)· 代码(占位)github.com/xyLiu339/FideDiff
- BlurDM: A Blur Diffusion Model for Image Deblurring — arxiv 2512.03979(NeurIPS 2025)· 代码 github.com/Jin-Ting-He/BlurDM
- Learning Deblurring Texture Prior from Unpaired Data with Diffusion Model (TP-Diff) — arxiv 2507.13599(ICCV 2025)· 代码 github.com/ChengxuLiu/TP-Diff
- Restoration-Aligned Generative Flow Models for Blind Motion Deblurring (DeblurFlow) — arxiv 2605.08854(2026-05)· 暂无公开代码
- Self-Diffusion Driven Blind Imaging (DeblurSDI) — arxiv 2510.27439(2025-10)· 代码 github.com/ggluo/Self-Diffusion
人脸去模糊 / 盲人脸复原(§3):
- FaceMe: Robust Blind Face Restoration with Personal Identification — arxiv 2501.05177(AAAI 2025)· 代码 github.com/modyu-liu/FaceMe
- HonestFace: Towards Honest Face Restoration with One-Step Diffusion Model — arxiv 2505.18469(2025-05)· 代码(待放)github.com/jkwang28/HonestFace
- AuthFace: Towards Authentic Blind Face Restoration with Face-oriented Generative Diffusion Prior — arxiv 2410.09864(arxiv 2024-10,ACM MM 2025 Oral)· 代码+数据 github.com/EthanLiang99/AuthFace
- LAFR: Efficient Diffusion-based Blind Face Restoration via Latent Codebook Alignment Adapter — arxiv 2505.23462(2025-05)· OpenReview
- ELIR: Efficient Image Restoration via Latent Consistency Flow Matching — arxiv 2502.03500(2025-02,人脸 BFR / 流匹配)· 代码 github.com/eladc-git/ELIR
- RealVDeblur: One-Step Diffusion for Generalizable Real-World Video Deblurring — arxiv 2607.20628(2026-07,视频)
- Restora-Flow: Mask-Guided Image Restoration with Flow Matching — arxiv 2511.20152(2025-11,通用复原)
讨论 / Comments
评论托管在本仓库的 GitHub Discussions, 需 GitHub 账号。